AI현장
"로봇의 두뇌는 클라우드에 있다"…연속 배칭의 주인공 전병곤 FriendliAI 대표가 그린 에이전트 시대의 추론 인프라
LLM 서빙의 표준을 만든 연구자 출신 창업자. 전병곤 FriendliAI 대표가 피지컬 AI 테크 데이 기조강연에서 에이전트와 로봇 두뇌를 돌릴 추론 인프라의 미래를 짚었다.
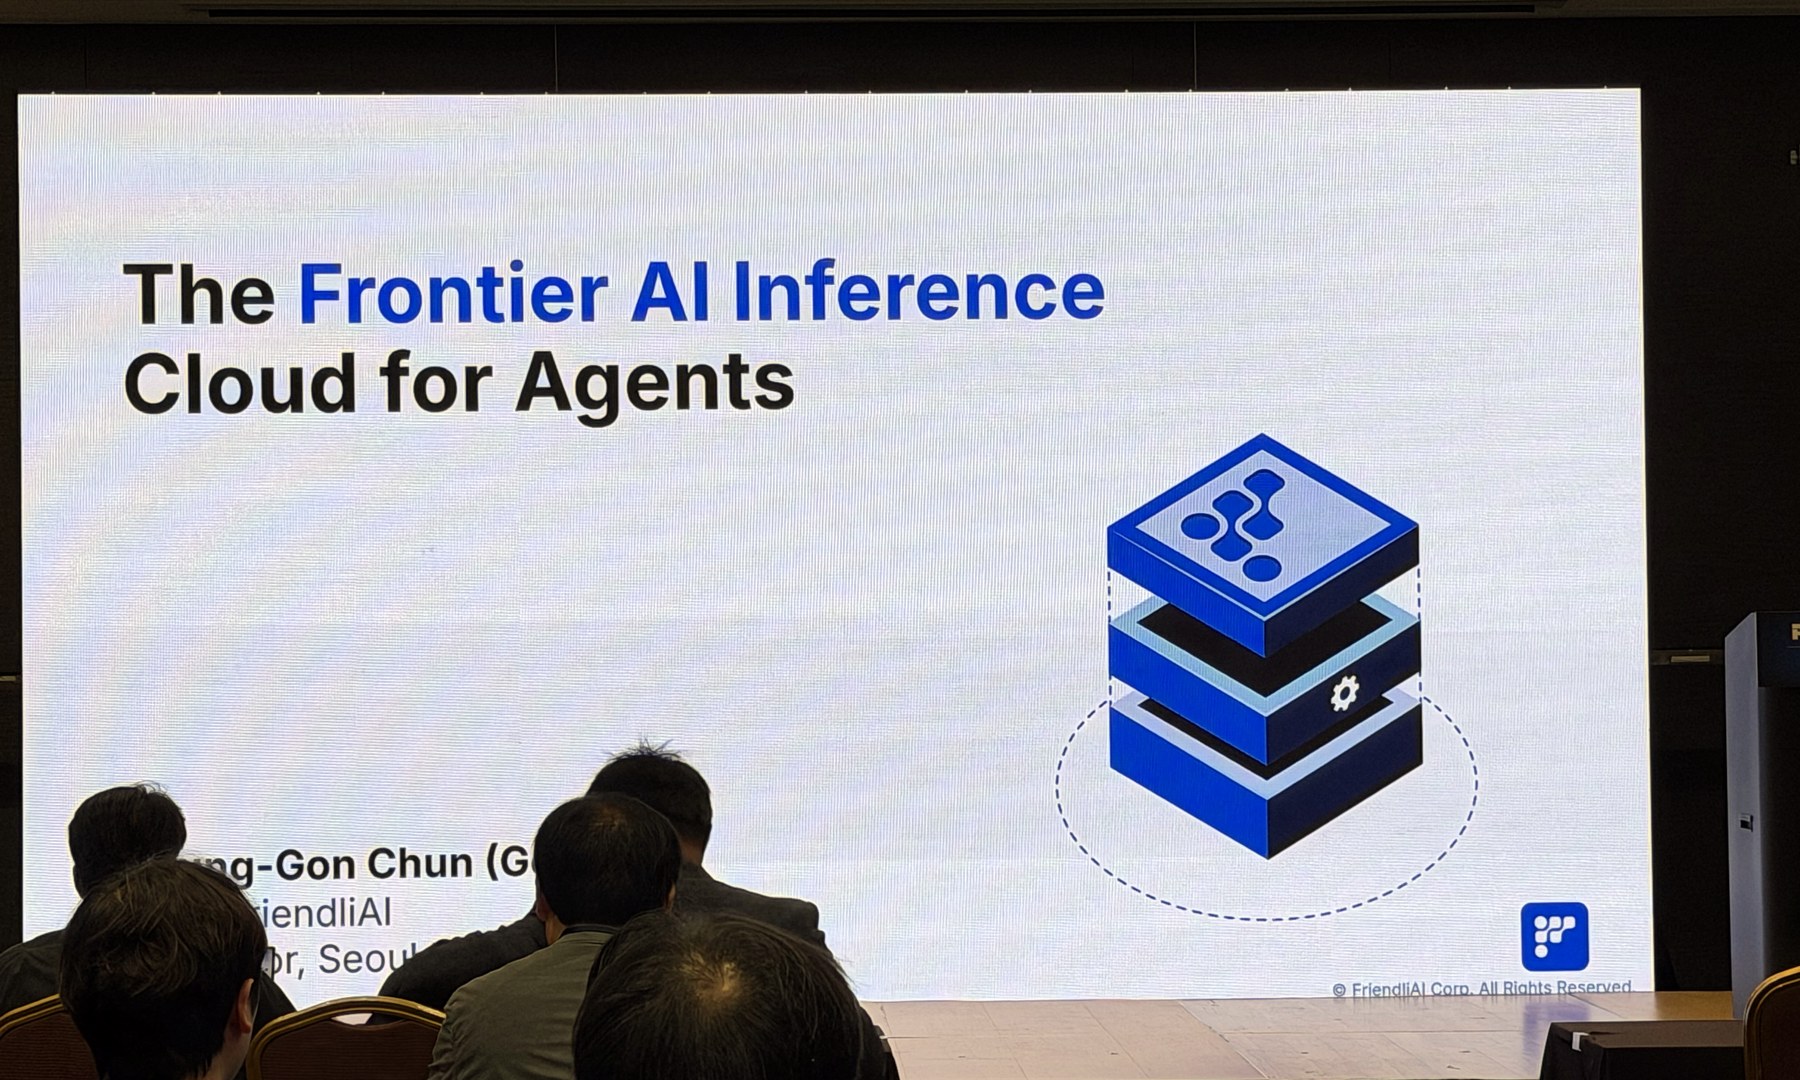
"2026년은 에이전트의 시대입니다."
14일 코엑스 피지컬 AI 테크 데이의 첫 기조강연 무대에 오른 전병곤 FriendliAI 대표는 로봇 이야기를 하러 온 자리에서 뜻밖에 에이전트부터 꺼냈다. 그리고 30여 분 동안, 로봇의 두뇌가 결국 에이전트와 같은 문제를 풀게 된다는 것을 하나씩 증명해 나갔다. 강연 제목은 'The Frontier AI Inference Cloud for Agents'였다.
로봇의 두뇌는 클라우드에 있다
흔히 로봇 AI라고 하면 로봇 안에서 도는 작은 모델을 떠올린다. 전 대표의 관점은 달랐다. 무엇이든 해내는 범용 로봇을 만들려면 큰 지능이 필요하고, 그 지능은 클라우드에서 돌면서 각 로봇이 배운 것을 모아 계속 똑똑해질 것이라는 설명이다. 언어 모델이 범용 대화를 가능하게 했듯, 로봇에도 범용적으로 생각하고 움직이는 '두뇌'가 필요하고 그건 프런티어급 모델이어야 한다고 그는 말했다.
에이전트의 시대, 승부처는 '추론'
전 대표는 지금 가장 먼저 바뀐 현장으로 개발을 꼽았다. 코딩 에이전트가 코드를 쓰고 테스트하고 고치는 일을 자동으로 해내면서, 프런티어 연구소 개발자들은 이미 일의 절반을 에이전트에 맡기고 내년에는 90%까지 맡길 것이라는 이야기를 전했다. 그는 "일하는 양이 같다면 그만큼 더 많은 일을 하게 되는 것"이라며 사람이 밀려나는 게 아니라 생산성이 몇 배로 커진다고 봤다.
코딩 에이전트도, 과학 문제를 푸는 에이전트도, 로봇의 두뇌도 구조는 같다. 도구를 쓰며 여러 턴을 돌고, 그때마다 이전 기록이 쌓여 맥락이 길어진다. 좋은 모델을 만드는 것만큼 중요한 것이 그 모델을 많은 사용자에게 동시에, 빠르게 제공하는 '추론(인퍼런스)'이라는 게 강연의 핵심이었다.
오픈 모델이 프런티어에 올라섰다
전 대표는 소프트웨어 엔지니어링 벤치마크를 보여주며 올해 오픈 모델이 비용 대비 성능에서 최전선에 올라섰다고 짚었다. 그만큼 로봇의 두뇌를 오픈 모델로 만들 수 있는 길이 열렸다는 뜻이다. 다만 그 최전선에 중국 모델이 많고 "안타깝게도 한국 모델은 없다"는 대목에서는 객석이 조용해졌다.
에이전트는 챗봇과 다르게 돈다
강연의 백미는 에이전트 워크로드에 대한 분석이었다. 마이크로소프트와 워싱턴대 연구를 인용해, 코딩 에이전트의 한 요청은 11만 6천 토큰의 맥락 위에 새 입력 886토큰, 출력 184토큰 정도라고 소개했다. 아주 긴 맥락을 반복해서 읽고 짧게 답하는 구조라, 챗봇에 맞춰진 하드웨어와 소프트웨어를 그대로 쓰면 비효율이 커진다는 것이다.
그래서 그는 맥락을 담는 메모리인 KV 캐시를 에이전트 시대의 핵심 자원으로 꼽았다. 수조 개 파라미터의 대형 모델은 4비트로 줄여도 최신 GPU 여러 대가 필요하고, 세션마다 수 GB씩 쌓이는 KV 캐시를 얼마나 아끼느냐가 동시에 처리할 수 있는 사용자 수를 결정한다. 모델 쪽에서는 희소 어텐션과 KV 압축이, 시스템 쪽에서는 효율적인 커널과 병렬화, 같은 앞부분을 재사용하는 캐시 기반 라우팅이 답이라고 설명했다. KV 캐시를 GPU 메모리에 둘지, 더 싼 메모리나 스토리지로 내릴지는 "비용의 결정"이라는 말도 남겼다.
추론 기술을 연 연구실에서 출발한 회사
FriendliAI는 이 모든 층을 하나로 묶는다. GPU 커널부터 모델별 최적화, 서빙 엔진, 여러 클러스터를 잇는 오케스트레이션까지 GPU와 오픈 모델 사이의 추론 인프라를 통째로 제공한다. 전 대표 연구팀이 개발한 연속 배칭(continuous batching) 기법은 오늘날 LLM 서빙의 사실상 표준이 됐다. 그 출발점이 된 연구가 2022년 OSDI에 발표된 Orca 논문이다.
전 대표는 사용자 300만 명 규모의 한 코딩 에이전트 고객이 다른 공급자보다 7배 빠른 속도와 낮은 오류율을 보고했고, 모델 API 중개 플랫폼 OpenRouter의 속도 순위에서도 앞서 있다고 소개했다. 그리고 다음 무대는 피지컬 AI, 로봇의 두뇌라며 강연을 맺었다.
에이전트와 로봇을 같은 문제로 묶어 낸 이날 강연은, 피지컬 AI가 로봇 하드웨어만의 이야기가 아니라 그 두뇌를 돌릴 인프라의 경쟁이기도 하다는 점을 선명하게 보여줬다.
피지컬 AI 테크 위크 2026 더 보기
다른 연사들의 발언과 행사 전체 흐름은 피지컬 AI 테크 위크 2026 총정리에서 볼 수 있다.
출처
AI 기사 더 보기
EVENTAI · Events
"여러분의 에이전트, 지금도 돌아가나요?"…씽킹AI 서밋 현장, 6명이 만든 대형 게임과 1인 증권 데이터 플랫폼
씽킹데이터에서 사명을 바꾼 씽킹AI가 4년째 서울 서밋을 열었다. 서광덕 한국 지사장, 서동진 넥스트증권 팀장, 강민석 언더독스 공동창업자가 AI의 속도를 실제 성장으로 바꾼 방법을 현장에서 숫자로 풀었다.
BRIEFAI · Products
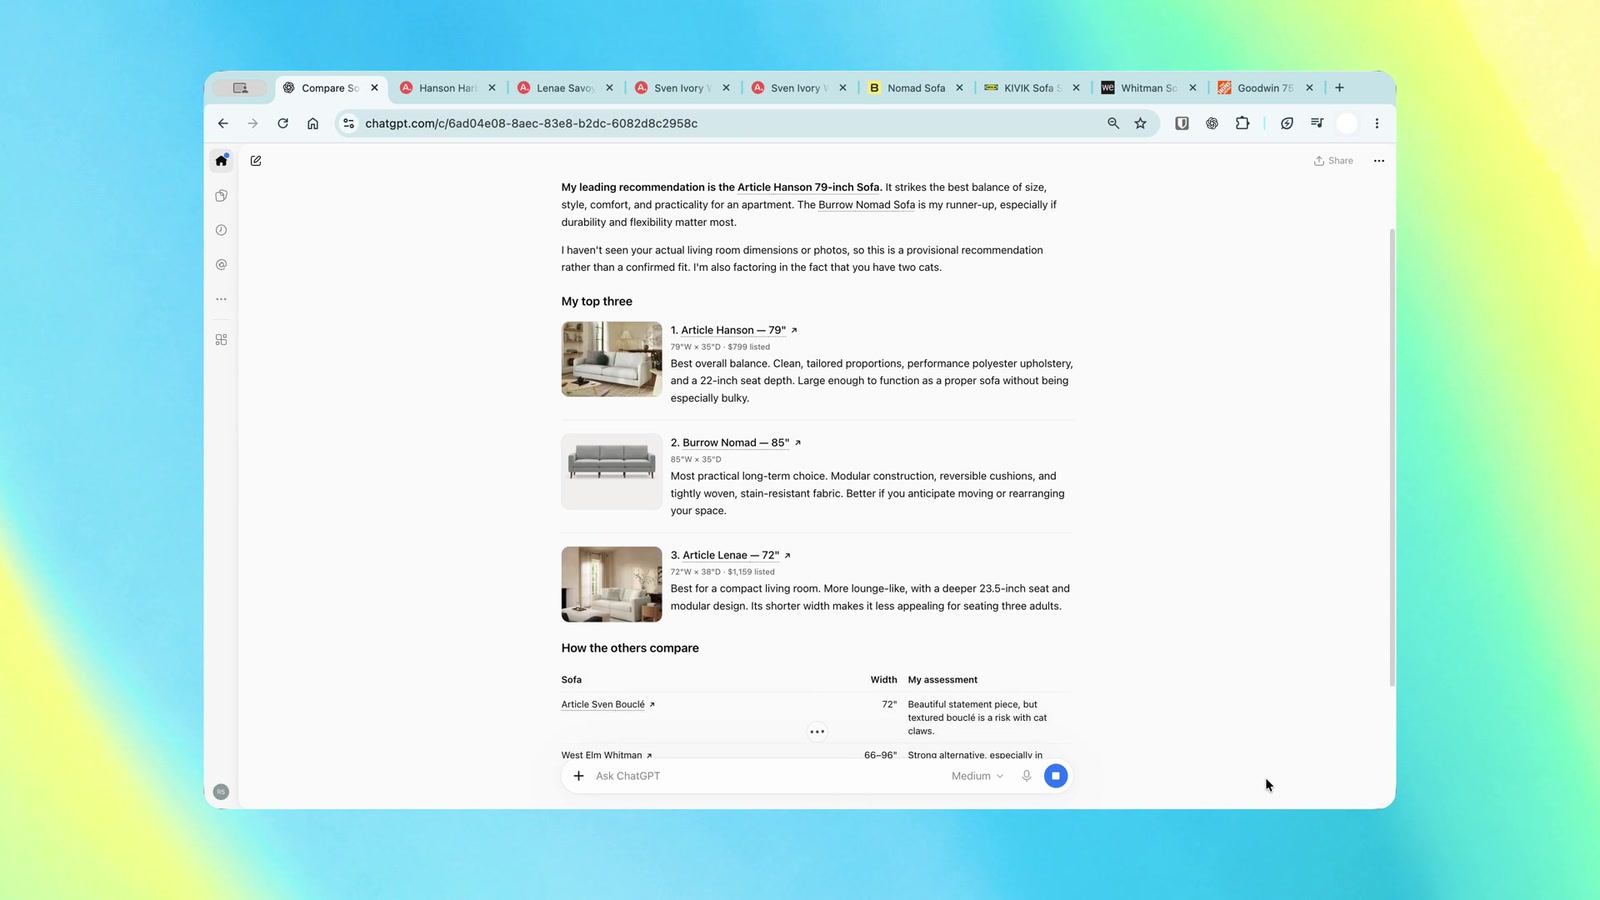
ChatGPT가 열어 둔 크롬 탭을 읽고 움직인다…기본은 '사이트마다 먼저 묻기'
ChatGPT가 크롬에 열린 탭을 훑어 답을 만들고, 작업 모드에서는 탭을 직접 조작한다. 쓰려면 데스크톱 앱과 브라우저 확장 프로그램이 필요하고, 사이트 허용 방식은 네 가지다.
BRIEFAI · Products
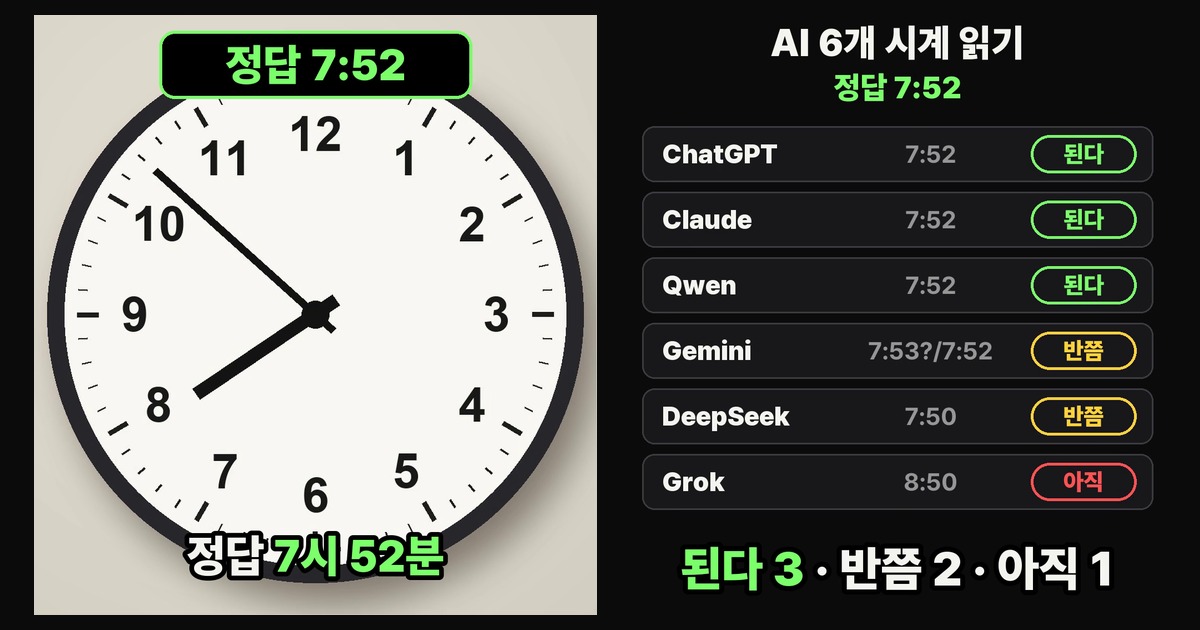
같은 시계 사진, AI 6개에 물었더니…정답 7시 52분 맞힌 건 3개
NEXTMADE가 ChatGPT·Gemini·Claude·Grok·DeepSeek·Qwen에 같은 아날로그 시계 사진을 보여 주고 몇 시 몇 분인지 물었다. 셋은 정확히 맞혔고 둘은 반쯤, Grok은 8시 50분이라고 답했다.